GEMA gegen Suno: Was das Münchner KI-Urteil für die vier Nutzungsphasen von KI-Modellen bedeutet
Fachanwältin für Urheber- und Medienrecht Profil ansehen
Am 31. Juli 2026 hat das Landgericht München I im Verfahren GEMA gegen Suno (Az. 42 O 763/25) sein zweites KI-Grundsatzurteil verkündet. Nach GEMA gegen OpenAI (Urteil vom 11. November 2025, Az. 42 O 14139/24), in dem es um Liedtexte ging, hatte die 42. Zivilkammer nun über einen KI-Musikgenerator zu entscheiden. Das Ergebnis ist deutlich: Suno darf sechs Werke aus dem GEMA-Repertoire – darunter „Atemlos durch die Nacht“, „Forever Young“ und „Daddy Cool“ – ohne Lizenz weder zum Training vervielfältigen noch im Modell speichern, über das Modell anbieten oder in Outputs wiedergeben. Bemerkenswert ist, dass die Kammer auch das Training untersagt hat, das in den USA stattfand – nach US-amerikanischem Recht und unter ausdrücklicher Ablehnung der Fair-Use-Verteidigung. Das Urteil ist nicht rechtskräftig; die Berufung ist beim OLG München anhängig (Az. 6 U 2314/26 e).
Zusammen mit den LAION-Entscheidungen des LG und OLG Hamburg und dem Urteil GEMA gegen OpenAI ergibt sich damit erstmals ein weitgehend geschlossenes Bild der deutschen Rechtsprechung. Die Gerichte beurteilen nicht „die KI“ als Ganzes, sondern unterscheiden vier aufeinanderfolgende Nutzungsphasen: die Erstellung des Datensatzes, das Training, das Angebot des Modells und den Output. Jede Phase bedeutet eigene Nutzungshandlungen, die eigene Rechtfertigungen brauchen. Dieser Beitrag stellt zunächst die Entscheidung vor und zeigt dann, was in jeder dieser Phasen derzeit gilt.
Was hat das LG München I entschieden?
Suno ist ein in den USA ansässiges Unternehmen, das einen KI-Musikgenerator betreibt. Nutzer geben einen Liedtext oder eine Beschreibung sowie einen Musikstil ein und erhalten binnen Sekunden zwei fertige Tonaufnahmen. Streitgegenständlich waren die Versionen v3.5 und v4, die auch in Deutschland abrufbar sind; technisch kombiniert das System ein Transformer- mit einem Diffusionsmodell.
Trainiert wurde in den USA mit Millionen vollständiger Tonaufnahmen. Die streitgegenständlichen Werke beschaffte Suno per Stream-Ripping von YouTube und umging dabei den sogenannten Rolling Cipher, eine technische Schutzmaßnahme gegen das Herunterladen. Das trainierte Modell wurde für Nutzer in Deutschland auf Edge-Servern in Deutschland vorgehalten.
Mitarbeiter der GEMA und ihrer Prozessbevollmächtigten gaben jeweils nur den Originalliedtext, den Werktitel und eine allgemeine Stilangabe ein, etwa „Schlager“ oder „80s, Synth pop, male voices“. Vorgaben zu Melodie, Harmonie, Rhythmus oder Arrangement enthielten die Prompts nicht. Je Werk wurde derselbe Prompt zwischen 4- und 176-mal eingegeben. Die vorgelegten Outputs gaben Melodien, Harmonien und Arrangements der Originale wiedererkennbar wieder; die Kammer hat sie in der mündlichen Verhandlung abgespielt und anhand von Notenauszügen verglichen.
Das Gericht hat Suno vier Verwertungshandlungen untersagt:
- die Vervielfältigung der Werke zu Trainingszwecken in den USA,
- die Vervielfältigung durch Speicherung in Form von Parametern im Modell in Deutschland (Memorisierung),
- die öffentliche Wiedergabe durch das Angebot des Modells und der Musik-Anwendung in Deutschland,
- die Vervielfältigung und öffentliche Wiedergabe von Umgestaltungen der Werke in den Outputs.
Hinzu kommen Ansprüche auf Auskunft und Schadensersatz dem Grunde nach sowie die Befugnis der GEMA, den Urteilstenor nach Rechtskraft auf Kosten von Suno in der Süddeutschen Zeitung bekannt zu machen. Abgewiesen hat die Kammer die Klage nur, soweit die GEMA eine öffentliche Zugänglichmachung nach § 19a UrhG geltend gemacht hatte (dazu unten, Phase 3).
Die Besonderheit: Ein Münchner Gericht urteilt über KI-Training in den USA
Neu gegenüber GEMA gegen OpenAI ist vor allem, dass die Kammer auch über das Training in den USA entschieden hat (Rn. 118 ff.). Drei Schritte tragen dieses Ergebnis:
- Zuständigkeit: 131 Abs. 1 VGG eröffnet Verwertungsgesellschaften einen Gerichtsstand am Ort der Verletzungshandlung. Nach § 131 Abs. 2 VGG können sie alle Ansprüche gegen denselben Verletzer bei einem dieser Gerichte bündeln. Die Kammer wendet die Norm „doppelfunktional“ auch auf die internationale Zuständigkeit an. Weil Suno seinen Musikgenerator in ganz Deutschland und damit auch in München anbietet, konnte die GEMA dort auch die in den USA begangenen Handlungen einklagen. Völkerrechtlich stützt die Kammer dies auf das Schutzprinzip; hilfsweise bejaht sie einen hinreichenden Inlandsbezug (Sitz der GEMA, überwiegend deutsche Urheber, enger Sachzusammenhang).
- Anwendbares Recht: Nach dem Schutzlandprinzip (Art. 8 Abs. 1 Rom II-VO) beurteilt sich das Training in den USA nach US-amerikanischem Recht, das Modell und die Outputs in Deutschland nach dem UrhG.
- Fair Use: Die Kammer prüft 17 U.S.C. § 107 selbst und verneint Fair Use; alle vier Faktoren sprechen gegen Suno (Rn. 447 ff.).
Besonders aufschlussreich ist die Abgrenzung zu den US-Entscheidungen Bartz v. Anthropic und Kadrey v. Meta, auf die sich Suno berufen hatte. Dort waren die Trainingsdaten in den Outputs nicht oder nicht substanziell zugänglich. Hier dagegen erzeugte der Musikgenerator auf einfache Prompts Tonaufnahmen, die den Originalen wesentlich ähnlich sind (Rn. 480). Das Training eines Musikgenerators könne zwar allgemein transformativ sein. Werden die Werke aber memorisiert und reproduziert, dienen Original und Output demselben Zweck – dem Anhören von Musik (Rn. 484, 494). Hinzu kam die Umgehung des Rolling Cipher, die die Kammer als bösgläubig und als Verstoß gegen 17 U.S.C. § 1201 wertete. Beim vierten Faktor sah sie in den Outputs ein Substitut der Originale auf dem Markt für Unterhaltungsmusik (Rn. 519 ff.). Den Unterlassungsanspruch sprach sie nach dem eBay-Standard zu; dabei fiel auch ins Gewicht, dass die GEMA ihre Lizenzbereitschaft erklärt hatte (Rn. 543).
Einordnung: Für Verwertungsgesellschaften ist ein Training im Ausland damit kein sicherer Hafen mehr. Ob ein Gerichtsstand, der nur Verwertungsgesellschaften offensteht, die Prüfung von US-Handlungen tatsächlich trägt, wird das OLG München klären müssen. Einzelne Rechteinhaber können sich auf § 131 VGG nicht stützen.
Das Vier-Phasen-Modell: So prüfen deutsche Gerichte KI-Nutzungen
Die Gerichte zerlegen den Lebenszyklus eines KI-Modells in zeitlich aufeinanderfolgende Phasen. Das LG Hamburg hat diese Unterscheidung im LAION-Verfahren entwickelt (Urteil vom 27. September 2024, Az. 310 O 227/23, Rn. 46); das LG München I hat sie übernommen (GEMA/Suno, Rn. 240): das Erstellen des Trainingsdatensatzes, das Training des Modells und die Nutzung des trainierten Modells durch Prompts und Outputs. Mit GEMA gegen Suno tritt eine eigenständige Phase hinzu: das Angebot des Modells, das die Kammer schon vor jedem Prompt als Verwertungshandlung wertet.
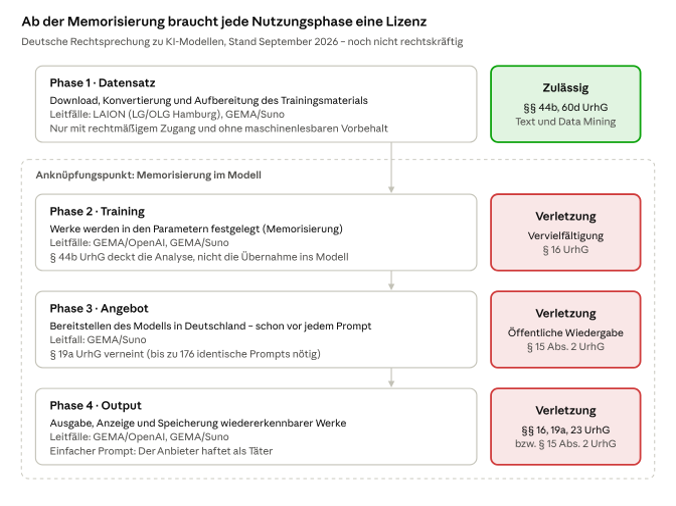 Die vier Nutzungsphasen von KI-Modellen und ihre Bewertung durch deutsche Gerichte
Der Gewinn dieser Betrachtung liegt in ihrer Trennschärfe. Jede Phase ist eine eigene Nutzungshandlung, die einer eigenen Rechtfertigung bedarf; eine Schranke, die in Phase 1 greift, trägt nicht automatisch in Phase 2. Das Scharnier ist die Memorisierung: Erst wenn ein Werk im Modell festgelegt ist, liegt dort eine Vervielfältigung vor – und diese Verletzung setzt sich über das Angebot des Modells bis in den Output fort.
Phase 1: Erstellung des Trainingsdatensatzes
Kurz gesagt: Das Sammeln und Aufbereiten von Werken für einen KI-Datensatz ist Text und Data Mining und nach §§ 44b, 60d UrhG grundsätzlich erlaubt – aber nur bei rechtmäßigem Zugang und wenn kein wirksamer, maschinenlesbarer Nutzungsvorbehalt besteht.
Leitfall für diese Phase ist das LAION-Verfahren. Der gemeinnützige Verein LAION hatte ein Foto von der Website einer Bildagentur heruntergeladen, um für einen öffentlichen Trainingsdatensatz Bild und Bildbeschreibung abzugleichen. Das LG Hamburg wies die Klage des Fotografen ab (Urteil vom 27. September 2024, Az. 310 O 227/23). § 44a UrhG greife zwar nicht, weil ein gezielter Download weder flüchtig noch begleitend sei. Die Vervielfältigung sei aber als Text und Data Mining zu Zwecken der wissenschaftlichen Forschung nach § 60d UrhG erlaubt. Ob auch § 44b UrhG greift, ließ das Gericht offen; es deutete aber an, dass ein Vorbehalt in natürlicher Sprache genügen könne.
Das OLG Hamburg hat die Berufung zurückgewiesen (Urteil vom 10. Dezember 2025, Az. 5 U 104/24) und neben § 60d nun auch § 44b UrhG bejaht. Entscheidend war der Zeitpunkt: Maßgeblich ist, ob der Vorbehalt im Zeitpunkt der Nutzung – hier des Downloads im zweiten Halbjahr 2021 – maschinenlesbar war. Das ließ sich nicht feststellen. Das OLG versteht Maschinenlesbarkeit technikoffen: Auch AGB oder ein Impressum können genügen, wenn der Text maschinell erfasst und so interpretiert werden kann, dass automatisierte Abläufe die Inhalte aussparen. Ob natürliche Sprache dafür ausreicht und welche Rolle robots.txt oder das TDM Reservation Protocol spielen, bleibt umstritten. Die Revision ist beim BGH anhängig (Az. I ZR 281/25) – es wird die erste höchstrichterliche Klärung der §§ 44b, 60d UrhG im Vorfeld des KI-Trainings sein.
GEMA gegen Suno bestätigt diese Linie im Grundsatz: § 44b UrhG und Art. 4 DSM-RL gelten auch für das KI-Training und decken die Vervielfältigungen zur Vorbereitung des Trainingskorpus, etwa Formatkonvertierungen oder Kopien im Arbeitsspeicher (Rn. 284 ff.). Neu ist eine wichtige Grenze: Die Schranke setzt einen rechtmäßigen Zugang zum Werk voraus (§ 44b Abs. 2 UrhG). Diesen hatte Suno nicht, weil es den Rolling Cipher von YouTube umgangen hatte. Die Kammer wertet ihn als wirksame technische Schutzmaßnahme im Sinne des § 95a UrhG – obwohl Suno die Umgehung gelungen ist. Wäre eine Maßnahme hundertprozentig wirksam, bräuchte es keinen rechtlichen Umgehungsschutz (Rn. 308 ff.). Ob wirksame Nutzungsvorbehalte erklärt worden waren, musste die Kammer deshalb nicht entscheiden.
Für die Praxis: Phase 1 ist die Domäne der TDM-Schranken. Wer Trainingsdaten per Stream-Ripping, aus Schattenbibliotheken oder unter Umgehung technischer Schutzmaßnahmen beschafft, kann sich darauf nicht berufen. Rechteinhaber sollten ihren Vorbehalt maschinenlesbar erklären und den Zeitpunkt dokumentieren.
Phase 2: Training und Memorisierung im Modell
Kurz gesagt: Sind Werke im Modell memorisiert, liegt eine Vervielfältigung nach § 16 UrhG vor. § 44b UrhG deckt die Analyse von Werken, nicht aber ihre Übernahme in das Modell – dafür ist eine Lizenz erforderlich.
Die Grundlage hat die Kammer in GEMA gegen OpenAI gelegt. ChatGPT gab auf einfache Prompts wie „Wie lautet der Text von …?“ neun Liedtexte, darunter „Atemlos“, „Männer“ und „Über den Wolken“, weitgehend wortgetreu wieder. Daraus schloss das Gericht, dass die Texte in den Modellen GPT-4 und GPT-4o festgelegt sind. Dass das Werk nur in Wahrscheinlichkeitswerten verteilt über die Parameter steckt, ist unerheblich: Art. 2 InfoSoc-RL erfasst Vervielfältigungen „auf jede Art und Weise und in jeder Form“. Die Kammer vergleicht das Modell mit einer progressiv gespeicherten JPEG-Datei oder einer MP3-Datei, bei der ebenfalls keine abgrenzbare Kopie erkennbar ist.
In GEMA gegen Suno überträgt die Kammer diese Linie auf Musik und schärft sie nach (Rn. 240 ff.):
- Was Memorisierung ist: Die Parameter entnehmen dem Trainingsdatum nicht nur Informationen wie Muster und Korrelationen, sondern übernehmen zumindest teilweise auch dessen Inhalt. Eine exakte, hundertprozentige Kopie ist nicht erforderlich (Rn. 243, 245).
- Wie sie bewiesen wird: Durch einen Abgleich von Original und Output, der auf einen einfachen, ergebnisoffenen Prompt entsteht. Bei hinreichend komplexen Werken scheidet Zufall als Ursache aus (Rn. 247 ff., 258). Ein Sachverständigengutachten hielt die Kammer nicht für nötig.
- Was ein einfacher Prompt ist: Liedtext, Titel und Genre legen Melodie, Harmonie, Rhythmus und Tempo nicht fest; sie sind daher kein steuernder Prompt (Rn. 253 ff.). Auch die wiederholte Eingabe desselben Prompts lenkt das Ergebnis nicht, weil Eingabe und Parameter gleich bleiben (Rn. 252).
- Was nicht verfängt: Der Einwand, das Modell könne rein rechnerisch nicht einmal 1 % der Trainingsdaten speichern, ist irrelevant – es kommt nur auf die sechs streitigen Werke an (Rn. 260). Für die mittelbare Wahrnehmbarkeit bedarf es auch keines „Parameterspielers“; der Musikgenerator selbst macht die Werke hörbar (Rn. 277).
Diese Vervielfältigung im Modell ist nicht durch § 44b UrhG gedeckt (Rn. 280 ff.). Text und Data Mining zielt auf die Gewinnung von Informationen; die Schranke erlaubt nur Vervielfältigungen „zum Zwecke“ dieser Analyse. Die im Modell verbleibende Kopie dient keiner weiteren Datenanalyse, sondern greift in die Verwertungsinteressen der Urheber ein. Eine analoge Anwendung scheidet aus, zumal das Risiko der Memorisierung allein aus der Sphäre des Modellanbieters stammt (Rn. 299). Deutlich formuliert die Kammer: Sollte Memorisierung nach dem Stand der Technik nicht vermeidbar sein, ist das Training mit geschützten Werken insgesamt nicht von der TDM-Schranke gedeckt (Rn. 304). Ein Geschäftsmodell, das sich kostenlos am geistigen Eigentum Dritter bedient, kenne die Rechtsordnung nicht (Rn. 305).
Auch der AI Act ändert daran nichts. Die Pflichten aus Art. 53 Abs. 1 lit. c und d KI-VO – Urheberrechtsstrategie und Zusammenfassung der Trainingsinhalte – sollen die Rechtsdurchsetzung erleichtern, ersetzen aber keine Lizenz. Der Praxisleitfaden (Code of Practice) stellt selbst klar, dass seine Einhaltung keine Einhaltung des Urheberrechts bedeutet (Rn. 300 ff.).
Für die Praxis: Die entscheidende Frage lautet nicht mehr, ob mit einem Werk trainiert wurde, sondern ob es im Modell memorisiert ist. Ist das der Fall, bedarf die Speicherung im Modell einer Lizenz – und zwar dort, wo das Modell gespeichert ist. Suno half es auch nicht, nach Schluss der mündlichen Verhandlung vorzutragen, die Modellgewichte lägen nicht mehr auf Servern in Deutschland; die Wiederholungsgefahr entfällt nur durch eine strafbewehrte Unterlassungserklärung (Rn. 312).
Phase 3: Angebot des Modells auf dem deutschen Markt
Kurz gesagt: Wer ein Modell mit memorisierten Werken in Deutschland anbietet, gibt diese Werke öffentlich wieder (§ 15 Abs. 2 UrhG) – unabhängig davon, ob ein Nutzer sie tatsächlich abruft.
Diese Phase ist die eigentliche Neuerung von GEMA gegen Suno. Die GEMA hatte in erster Linie eine öffentliche Zugänglichmachung nach § 19a UrhG geltend gemacht. Das lehnte die Kammer ab: § 19a verlangt einen Zugriff „zu Zeiten ihrer Wahl“. Wenn bis zu 176 identische Prompts nötig sind, um ein Werk zu erhalten, ist das nicht der Fall. Die GEMA hatte zwar vorgetragen, weitere rechtsverletzende Outputs erhalten zu haben, diese aber nicht vorgelegt (Rn. 316).
Erfolg hatte dagegen der Hilfsantrag. Die Kammer bejaht einen Eingriff in das unbenannte Recht der öffentlichen Wiedergabe nach § 15 Abs. 2 UrhG, das sie richtlinienkonform aus Art. 3 Abs. 1 InfoSoc-RL ableitet (Rn. 369 ff.):
- Handlung der Wiedergabe: Durch das Angebot des Modells und der Anwendung eröffnet Suno den Zugang zu den memorisierten Werken. Schon diese Möglichkeit des Abrufs genügt. Wie beim Recht des Online-Verfügbarmachens nach Art. 8 WCT kommt es auf das vorgelagerte Anbieten an, nicht auf den tatsächlichen Abruf (Rn. 376 f.).
- Unmittelbar, nicht als Vermittler: Suno stellt nicht nur Infrastruktur bereit, sondern bestimmt durch Auswahl der Trainingsdaten, Training und Architektur den Inhalt der Outputs. Die Kriterien der mittelbaren Wiedergabe – zentrale Rolle und Vorsätzlichkeit – müssen deshalb nicht geprüft werden; sie lägen aber ohnehin vor (Rn. 378 ff.).
- Kenntnis: Das Phänomen der Memorisierung ist in Fachkreisen spätestens seit der Studie von Carlini et al. aus dem Jahr 2021 bekannt. Anleitungen, wie man mit Suno Coverversionen bekannter Lieder erstellt, kursieren öffentlich (Rn. 382).
- Öffentlichkeit: Der Dienst steht jedem offen, der sich registriert; 2024 verzeichnete er 2,2 Millionen Besucher in einem Monat. Selbst wenn nur jede vierte oder jede 176. Eingabe ein im Wesentlichen ähnliches Stück liefert, ist eine Vielzahl von Personen erreicht (Rn. 386, 394).
Für die Praxis: Die Verletzung liegt damit schon im Anbieten des Modells, nicht erst in einem einzelnen Prompt. Das Modell selbst wird zum öffentlich zugänglichen Werkspeicher. Für die Rechtsdurchsetzung zeigt die Entscheidung zugleich eine Beweislinie auf: Wiederholte Prompts reichen, um die Memorisierung (§ 16 UrhG) zu belegen, nicht aber für § 19a UrhG. Rechteinhaber sollten deshalb alle Outputs dokumentieren und vorlegen, nicht nur den eindrücklichsten.
Phase 4: Prompt und Output
Kurz gesagt: Outputs, in denen geschützte Werke wiedererkennbar sind, verletzen die Rechte der Urheber (§§ 16, 23 UrhG sowie § 19a bzw. § 15 Abs. 2 UrhG). Bei einfachen Prompts haftet der Anbieter als Täter; nur bei stark steuernden Prompts kann der Nutzer selbst zum Täter werden.
Wiedererkennbarkeit: Maßstab ist nicht der Gesamteindruck, sondern ob kreative Elemente des Werks wiedererkennbar übernommen wurden – schon ein kleiner Teil kann genügen, wenn er die eigene geistige Schöpfung des Urhebers zum Ausdruck bringt (EuGH, Mio; EuGH, Pelham II). Bei Musik kommt es auf das Hörverständnis eines durchschnittlichen Musikhörers an. Da die Kammermitglieder selbst zu diesem Kreis gehören, verzichtete das Gericht auf ein Sachverständigengutachten (Rn. 323). Es hörte die Aufnahmen und verglich Notenauszüge: Beim Output zu „Atemlos durch die Nacht“ etwa stimmen Tempo und Tonart überein, und die gesamte kompositorische Dramaturgie vom Pre-Refrain bis zum Post-Refrain wird übernommen (Rn. 326 ff.).
Haftung: Für das Vervielfältigungsrecht fragt die Kammer im Anschluss an den BGH (Manhattan Bridge, I ZR 112/23), wer die Tatherrschaft hat. Bei einfachen, ergebnisoffenen Prompts ist das der Anbieter: Er wählt die Trainingsdaten aus, trainiert das Modell und verantwortet dessen Architektur und die Memorisierung. Der Nutzer löst die Ausgabe nur aus (Rn. 399 ff.). Anders als ein Internet-Radiorecorder ist das Modell kein bloßes Aufnahmegerät, und anders als ein Marktplatzbetreiber trägt der Anbieter inhaltliche Verantwortung. In GEMA gegen OpenAI hatte die Kammer die Gegenkonstellation angedeutet: Bei einer komplexen Steuerung, die vom Sinn der Werke wegführt – als Beispiel diente ein 13-teiliges Worträtsel –, kann der Nutzer Täter sein. Wo genau die Grenze verläuft, ist offen.
Keine Schranke, kein Haftungsprivileg:
- 44a UrhG greift nicht: Die Zwischenspeicherung auf Edge-Servern hat eine eigenständige wirtschaftliche Bedeutung, weil Nutzer den Output schon während der Generierung anhören können (Rn. 403 ff.).
- 6 DSA hilft nicht: Outputs auf einfache Prompts sind eigene Informationen des Anbieters, keine fremden Informationen der Nutzer (Rn. 408 ff.).
- Zitat, Pastiche, Privatkopie: Schon in GEMA gegen OpenAI hatte die Kammer auch §§ 51, 51a und 53 UrhG verneint.
Für die Praxis: Output-Filter und Takedown-Verfahren mögen Rechtsverletzungen im Output reduzieren; die Memorisierung im Modell (Phase 2) und das Angebot des Modells (Phase 3) lassen sie unberührt. Für die Frage, ob ein Prompt „einfach“ oder „provozierend“ war, kommt es auf dessen Inhalt an – nicht auf die Zahl der Wiederholungen.
Welche Fragen bleiben offen?
Keine der genannten Entscheidungen ist rechtskräftig. Die Linie kann sich in den nächsten Monaten noch verschieben:
| Verfahren | Gericht | Aktenzeichen | Kernfrage |
| LAION | BGH | I ZR 281/25 | Anforderungen an einen maschinenlesbaren Vorbehalt; Reichweite der §§ 44b, 60d UrhG |
| GEMA gegen OpenAI | OLG München | 6 U 3662/25 e | Memorisierung als Vervielfältigung; Haftung für Outputs |
| GEMA gegen Suno | OLG München | 6 U 2314/26 e | zusätzlich: Angebot als öffentliche Wiedergabe; Zuständigkeit für US-Training |
| Like Company gegen Google | EuGH | C-250/25 | Output, Training, TDM und Vervielfältigung durch den Anbieter (Gemini) |
| Manchester United Fanatics Klub gegen Google | EuGH | C-806/26 | zusätzlich: Prompt-Input, Einwilligung und Opt-out |
Die beiden ungarischen Vorlagen betreffen zwar das Presseverlegerrecht. Die Auslegung von Art. 2 und 3 InfoSoc-RL und Art. 4 DSM-RL, um die es dort geht, gilt aber für alle Werkarten. In Like Company hat die Große Kammer am 10. März 2026 verhandelt. Das LG München I hat eine eigene Vorlage für entbehrlich gehalten, weil die Rechtsprechung des EuGH zur Vervielfältigung und öffentlichen Wiedergabe geklärt sei und der Fall schon nicht in den Anwendungsbereich der TDM-Schranke falle (Rn. 555 ff.).
Offen bleiben insbesondere vier Punkte:
- Trägt ein Gerichtsstand, der nur Verwertungsgesellschaften offensteht (§ 131 VGG), die Prüfung von Trainingshandlungen in den USA?
- Wo verläuft die Grenze zwischen einem einfachen und einem provozierenden Prompt?
- Welche Form muss ein Nutzungsvorbehalt haben, um „maschinenlesbar“ zu sein?
- Wie viele Versuche verträgt die öffentliche Zugänglichmachung nach § 19a UrhG noch?
Die nächsten Verfahren stehen bereits an: Vor der 42. Zivilkammer des LG München I klagen zwei Kinderbuchverlage gegen OpenAI – die PRH Verlagsgruppe mit Ingo Siegner wegen „Der kleine Drache Kokosnuss“ und der Carlsen Verlag mit Marc-Uwe Kling und Astrid Henn wegen „Das NEINhorn“. Dort geht es neben Texten auch um Figuren und Cover.
Häufige Fragen (FAQ)
Ist KI-Training mit geschützten Werken in Deutschland jetzt verboten?
Nicht alle Schritte des Trainings. Das Sammeln und Analysieren von Werken für einen Trainingsdatensatz bleibt als Text und Data Mining zulässig, sofern der Zugang rechtmäßig ist und kein wirksamer Nutzungsvorbehalt besteht. Unzulässig ohne Lizenz ist nach der Münchner Rechtsprechung, dass Werke nach dem Training im Modell memorisiert enthalten sind und über das Modell und seine Outputs wieder abrufbar sind.
Schützt ein Training im Ausland vor Ansprüchen nach deutschem Recht?
Nicht zuverlässig. Wird das Modell in Deutschland angeboten oder auf Servern in Deutschland gespeichert, richten sich Memorisierung, Angebot und Output nach dem UrhG. Für Verwertungsgesellschaften hat das LG München I darüber hinaus auch über das Training in den USA entschieden – nach US-Recht und ohne Fair Use.
Genügt ein Nutzungsvorbehalt im Impressum?
Das ist nicht abschließend geklärt. Nach dem OLG Hamburg kommt es darauf an, dass der Vorbehalt im Zeitpunkt der Nutzung maschinell erfasst und ausgewertet werden kann. Bis zur Entscheidung des BGH empfiehlt sich eine Kombination: robots.txt, TDM Reservation Protocol und eine klare Erklärung in Nutzungsbedingungen oder Impressum, jeweils mit dokumentiertem Datum.
Wer haftet, wenn ein Nutzer mit einem Prompt ein geschütztes Werk erzeugt?
Bei einfachen, ergebnisoffenen Prompts – etwa Liedtext, Titel und Genre – haftet der Anbieter des Modells als Täter. Steuert der Nutzer das Ergebnis mit komplexen, provozierenden Vorgaben, kann er selbst zum Täter werden. Wer Outputs weiterverwendet, etwa veröffentlicht, trägt dafür ohnehin eigene Verantwortung.
Reicht es, die Pflichten des AI Act zu erfüllen?
Nein. Urheberrechtsstrategie und Trainingsdaten-Zusammenfassung nach Art. 53 KI-VO sind Transparenz- und Compliance-Pflichten. Sie ersetzen weder eine Lizenz noch eine Schranke.
Gilt das nur für Musik und Liedtexte?
Nein. Die Maßstäbe zu Vervielfältigung, öffentlicher Wiedergabe und TDM-Schranke gelten für alle Werkarten – für Bücher, Fotos, Illustrationen, Filme und Software ebenso wie für Musik. Die anhängigen Klagen der Kinderbuchverlage werden zeigen, wie die Gerichte Figuren und Bildwerke behandeln.
Praxishinweis für Rechteinhaber und KI-Anbieter
Das Vier-Phasen-Modell gibt beiden Seiten ein klares Prüfraster an die Hand: Für jede Phase ist gesondert zu fragen, welche Handlung vorliegt und was sie rechtfertigt.
Für Rechteinhaber – Musikverlage, Buchverlage, Bildagenturen, Film- und Medienunternehmen:
- Nutzungsvorbehalte maschinenlesbar erklären und das Datum der Erklärung dokumentieren.
- KI-Modelle mit einfachen, ergebnisoffenen Prompts testen und sämtliche Prompts und Outputs mit Datum und Modellversion sichern – nicht nur den eindrücklichsten Treffer.
- Prüfen, ob eine Durchsetzung über eine Verwertungsgesellschaft sinnvoll ist, die den Gerichtsstand nach § 131 VGG nutzen kann.
- Lizenzmodelle für Training und Output entwickeln; die Lizenzbereitschaft kann sich, wie in GEMA gegen Suno, auch prozessual auswirken.
Für KI-Anbieter und Unternehmen, die Modelle einsetzen:
- Die Herkunft der Trainingsdaten prüfen und dokumentieren; keine Beschaffung unter Umgehung technischer Schutzmaßnahmen.
- Nutzungsvorbehalte technisch auslesen und beachten.
- Maßnahmen gegen Memorisierung treffen und dokumentieren, etwa Deduplizierung der Trainingsdaten und Tests auf Regurgitation vor dem Rollout.
- Nicht darauf vertrauen, dass ein Training im Ausland oder die Erfüllung des AI Act die urheberrechtliche Prüfung ersetzt.
- Beim Einkauf von KI-Lösungen vertragliche Freistellungen und Gewährleistungen zur Rechtekette vereinbaren.
Wir beraten Rechteinhaber, Verlage, Medienunternehmen und Anbieter von KI-Systemen zu allen Fragen rund um KI und Urheberrecht – von der Erklärung von Nutzungsvorbehalten, Audits und umfassenden Beweissicherungen aktueller KI-Modelle bis zur Rechtsdurchsetzung und Lizenzgestaltung. Sprechen Sie uns gerne an.